


Messen & Tracking
LLM‑Sichtbarkeit‑Tracking: Warum KI‑Erwähnungen jetzt zählen
LLM‑Sichtbarkeit‑Tracking: Warum KI‑Erwähnungen jetzt zählen
Ja, LLM‑Sichtbarkeit lässt sich messen. Coverage, Erwähnungsrate, Platzierung und Tonalität gehören inzwischen genauso ins Brand‑Reporting wie Rankings und Backlinks. Wer heute noch ohne llm sichtbarkeit tracking arbeitet, verpasst genau die Kanäle, über die Kunden gerade Kaufentscheidungen vorbereiten. Es gibt kostenlose Einstiegschecks, die zeigen, ob und wie eine Marke aktuell in ChatGPT auftaucht.
Kurz gesagt:
- Eine kontinuierliche Messung der Markenabsicht in Sprachmodellen ist essenziell, um Kaufentscheidungen frühzeitig zu erkennen und auf aktuelle Influencer- oder Quellenwechsel zu reagieren.
- Die wichtigsten Kennzahlen sind die Abdeckung der Marken in Prompts, die Nennhäufigkeit, die Platzierung innerhalb der Antworten sowie die Tonalität und Stimmung.
- Es ist entscheidend, zwischen Erwähnungen aus aktuellen Webquellen (Retrieval) und fest im Modell verankertem Wissen zu unterscheiden, um gezielt Maßnahmen zu priorisieren.
- Für zuverlässiges Tracking empfehlen sich modellübergreifende Tools mit automatisiertem Prompt‑Scheduling, Archivierung und Drift‑Erkennung, um Trends präzise zu beobachten.
- Ein kleiner, konsequent durchgeführter Prompt‑Katalog mit wöchentlicher Wiederholung liefert langfristig eine belastbare Datenbasis, um Wettbewerbs- und Markenentwicklung agil zu steuern.
Inhaltsverzeichnis
- Was Ist LLM‑Sichtbarkeit Und Wie Unterscheidet Sie Sich Von SEO?
- Welche Kennzahlen Sollten Sie Sofort Einführen?
- Welche Tool‑Funktionen Braucht Verlässliches LLM‑Monitoring?
- Wie Erkennen Sie, Ob Eine Nennung Aus Retrieval Oder Modellwissen Stammt?
- Wie Bauen Sie Einen Praktischen Tracking‑Workflow Auf?
- Welche Schritte Und Ressourcen Braucht Die Umsetzung?
- Praxisbeleg: Erfahrung Von Harald Pfanner Und growResonance
- Warum LLM‑Tracking Jetzt Priorität Haben Sollte
- growResonance: Ihr Einstieg In Messbares LLM‑Tracking
- Quellen
- FAQ
Was Ist LLM‑Sichtbarkeit Und Wie Unterscheidet Sie Sich Von SEO?
LLM‑Sichtbarkeit beschreibt, ob und wie eine Marke in den Antworten von Sprachmodellen wie ChatGPT, Claude, Perplexity oder Gemini erwähnt wird. Klassisches SEO fragt: Wo steht meine Seite in den Suchergebnissen? Die Sichtbarkeit von LLM fragt etwas anderes: Nennt mich das Modell überhaupt, wenn jemand eine Kaufentscheidung vorbereitet?
Drei Ebenen sind dabei zu unterscheiden:
- Generative Answer Visibility: Wird die Marke direkt im Fließtext der KI‑Antwort genannt, ohne dass eine Quelle sichtbar zitiert wird?
- Retrieval‑ oder Referenced Visibility: Zitiert das Modell eine konkrete Quelle, etwa eine Produktseite oder einen Testbericht, aus der die Nennung stammt?
- Embeddings‑ beziehungsweise Entity Visibility: Ist die Marke im Modell selbst als Entität mit klaren Assoziationen verankert, unabhängig von einer aktuellen Websuche?
Diese drei Ebenen brauchen unterschiedliche Kennzahlen. Ein reines Ranking‑Tool erfasst keine davon. Und weil die Modelle sich in Trainingsdaten, Aktualität und Antwortstil unterscheiden, muss Tracking für llm modellübergreifend laufen. Eine Marke kann in Perplexity stark vertreten sein und in Gemini praktisch unsichtbar bleiben. Genau das macht LLM‑Tracking zu einer eigenständigen Disziplin, nicht zu einem Anhang der klassischen SEO‑Analyse.
Welche Kennzahlen Sollten Sie Sofort Einführen?
Vier Kennzahlen bilden das Grundgerüst für jede seriöse llm performancemessung:
- Coverage (Abdeckung): Der Anteil relevanter Prompts, bei denen die Marke überhaupt in der Antwort auftaucht, gemessen über ein festes Prompt‑Set und mehrere Modelle.
- Mention Rate beziehungsweise Citation Rate: Wie oft wird die Marke namentlich genannt oder als Quelle zitiert, im Verhältnis zu allen getesteten Antworten im Beobachtungszeitraum?
- Platzierung in der Antwort (Top‑N): Steht die Marke an erster Stelle einer Aufzählung, mittendrin oder nur am Rand? Frühe Nennungen wiegen in der Wahrnehmung schwerer.
- Sentiment und Tonalität: Wird die Marke positiv, neutral oder kritisch dargestellt? Ein häufiges Zitat mit negativer Einordnung ist kein Erfolg.
Dazu kommt die Prompt‑Coverage über mehrere Modelle, also der Share of Voice im Vergleich zu Wettbewerbern, aufgeschlüsselt nach ChatGPT, Perplexity, Claude und Gemini einzeln. LLM‑Sichtbarkeit ist dabei keine einzelne Kennzahl, sondern eine Mischung aus Prompt‑Abdeckung, Erwähnungen, Zitierhäufigkeit und Quellen‑Einfluss, die erst im Zusammenspiel ein belastbares Bild ergibt.
Profi‑Tipp: Berechnen Sie die Mention Rate nie über ein einmaliges Prompt‑Set. Modelle antworten bei identischer Frage nicht immer identisch. Erst eine Wiederholung über mehrere Tage zeigt, ob eine Nennung stabil ist oder Zufall war.
Mit rund 900 Millionen wöchentlichen aktiven Nutzern von ChatGPT entscheidet sich ein spürbarer Teil der Markenwahrnehmung inzwischen in genau diesen vier Kennzahlen, nicht mehr nur in der klassischen Suche.
Welche Tool‑Funktionen Braucht Verlässliches LLM‑Monitoring?
Nicht jedes llm monitoring tool hält, was das Marketing verspricht. Bevor Sie ein Budget dafür einplanen, sollten diese Funktionen vorhanden sein:
- Modellübergreifende Abdeckung: ChatGPT, Perplexity, Claude, Gemini und Google AI Overviews müssen parallel abgefragt werden, nicht nur eines davon.
- Automatisiertes Prompt‑Scheduling: Wiederkehrende Abfragen laufen nach Zeitplan, ohne dass jemand jeden Prompt händisch eintippt.
- Archiv historischer Antworten: Alte Ergebnisse bleiben nachvollziehbar gespeichert, sonst lässt sich keine Entwicklung über Zeit zeigen.
- Versions‑ und Drift‑Erkennung: Modell‑Updates verändern Antworten manchmal grundlegend, ohne dass die eigene Marke etwas verändert hat.
- Metadaten‑Extraktion: Entitäten, Schlüsselbegriffe, Sentiment und Quellenhinweise werden automatisch aus dem Antworttext herausgelöst.
- Anbindung an Dashboards und Alerting: Auffällige Verschiebungen müssen automatisch gemeldet werden, nicht erst beim nächsten manuellen Report auffallen.
LLM‑Tracking kombiniert im Kern Prompt‑Automatisierung, Archivierung historischer Antworten und Drift‑Erkennung; die Einbindung in bestehende Dashboards gilt dabei als Best Practice, nicht als optionales Extra.
Profi‑Tipp: Fragen Sie jeden Anbieter direkt, wie oft ein Prompt‑Set pro Woche wiederholt wird. Wöchentliche Stichproben reichen für ein grobes Bild, tägliches Tracking für belastbare Trendlinien im Kundenreport.
Versions‑ und Drift‑Tracking sind deshalb kein Nice‑to‑have: Modell‑Updates können narrative Verschiebungen auslösen, die mit der eigenen Arbeit nichts zu tun haben, aber im Report wie ein Rückgang aussehen, wenn niemand die Ursache kennt.
Wie Erkennen Sie, Ob Eine Nennung Aus Retrieval Oder Modellwissen Stammt?
Diese Unterscheidung entscheidet darüber, wo Sie Ihre Arbeitszeit investieren. Eine Nennung aus Retrieval entsteht, weil das Modell live im Web nachschaut. Eine Nennung aus Modellwissen sitzt fest im trainierten Modell selbst, unabhängig von einer aktuellen Suche.
Der Test ist einfach:
- Stellen Sie dieselbe Frage einmal mit aktivierter Websuche beziehungsweise Grounding.
- Stellen Sie dieselbe Frage ein zweites Mal ohne Websuche, rein aus dem Modellgedächtnis.
- Vergleichen Sie die vier möglichen Ergebnisse: Nennung nur mit Suche, nur ohne Suche, in beiden Fällen, oder in keinem.
Der Test mit und ohne Websuche zeigt, ob eine Erwähnung aus Retrieval oder aus im Modell verankertem Wissen stammt, und genau davon hängt die richtige Priorisierung ab.
| Testergebnis | Wahrscheinliche Ursache | Erwartete Reaktionszeit |
|---|---|---|
| Nur mit Websuche genannt | Reine Retrieval‑Quelle, aktueller Content wirkt schnell | Tage bis wenige Wochen |
| Nur ohne Websuche genannt | Feste Verankerung im Modellwissen | Erst nach neuem Trainingszyklus |
| In beiden Fällen genannt | Starke, doppelt abgesicherte Sichtbarkeit | Bereits stabil |
| In keinem Fall genannt | Echte Sichtbarkeitslücke | Sofortiger Handlungsbedarf |
Fehlt eine Marke nur ohne Websuche, hilft kurzfristig kein Contentprojekt. Modellwissen ändert sich erst mit dem nächsten Training des Anbieters, das kann Monate dauern. Fehlt sie dagegen auch mit Websuche, braucht es Onsite‑Arbeit an Produktseiten und strukturierten Daten sowie PR‑ und Quellenarbeit, damit überhaupt zitierfähiges Material im Netz existiert.
Wie Bauen Sie Einen Praktischen Tracking‑Workflow Auf?
Ein funktionierender Workflow beginnt mit dem Prompt‑Set, nicht mit dem Tool. Vier Prompt‑Kategorien decken die relevanten Suchsituationen ab:
- Markenbezogene Prompts: direkte Fragen nach der eigenen Marke oder dem Produktnamen.
- Generische Prompts: Fragen zur Produktkategorie ohne Markennennung, etwa „beste Software für X“.
- Vergleichs‑Prompts: „X gegen Y“ oder „Alternativen zu X“.
- Kommerzielle Prompts: kauf nahe Formulierungen wie „welches Tool lohnt sich für kleine Agenturen“.
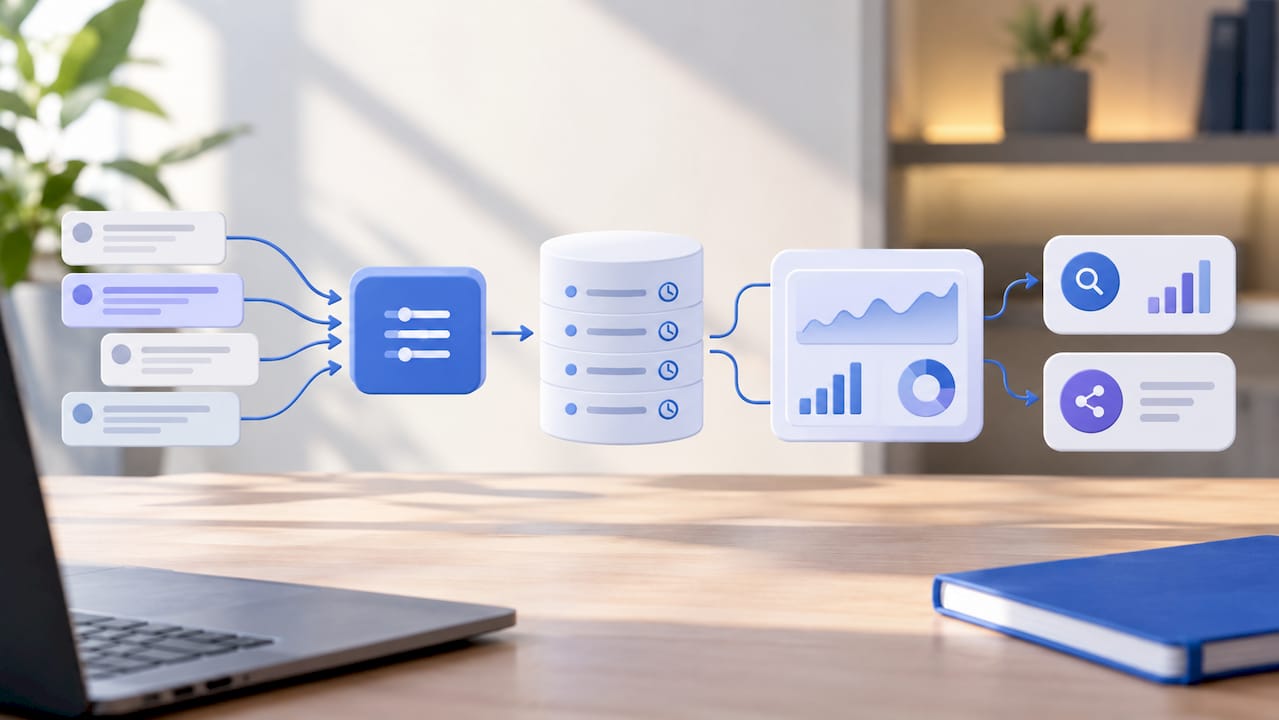
Jede Kategorie braucht ein festes Sampling: dieselben zehn bis zwanzig Prompts, wiederholt über einen definierten Zeitraum, damit einzelne Ausreißer nicht die ganze Baseline verzerren. Einheitliche Prompts und automatisierte Wiederholungen schaffen verlässliche Baselines; ohne diese Standardisierung sind Ergebnisse von Monat zu Monat kaum vergleichbar.
Nach der Erfassung folgt die Archivierung: Rohantworten normalisiert speichern, Modellversion dokumentieren, Zeitstempel setzen. Erst danach lohnt sich die Integration in bestehende BI‑Dashboards, wo sich KI‑Erwähnungen mit klassischen Performance‑Signalen aus SEO und Social Media korrelieren lassen. Eine ausführlichere Anleitung zur Metrik‑Berechnung finden Sie im Leitfaden zur Messung der LLM‑Sichtbarkeit.
Profi‑Tipp: Legen Sie das Prompt‑Set schriftlich fest, bevor Sie mit dem Tracking beginnen. Wird das Set nachträglich verändert, verlieren Sie die Vergleichbarkeit zur ersten Baseline, und der ganze Trendverlauf wird wertlos.
Welche Schritte Und Ressourcen Braucht Die Umsetzung?
Die Reihenfolge entscheidet über den Erfolg mehr als das gewählte Tool:
- Baseline erfassen: aktuellen Stand über alle relevanten Modelle einmal vollständig dokumentieren.
- Tool auswählen, das modellübergreifend arbeitet und Archivierung sowie Drift‑Erkennung mitbringt.
- Prompt‑Set final festlegen und Wiederholungsrhythmus bestimmen, mindestens wöchentlich.
- Integration in bestehende Dashboards und Alerting einrichten, damit Auffälligkeiten sofort auffallen.
- Reporting‑Rhythmus mit Kunden oder Geschäftsführung abstimmen, monatlich oder quartalsweise.
Für den laufenden Betrieb braucht es eine feste Zuständigkeit, meist eine Person aus dem SEO‑ oder Content‑Team, ein Budget für API‑Aufrufe je nach Prompt‑Volumen und einen festen Speicherplatz für die Antwortarchive. Ein Review‑Rhythmus von zwei bis vier Wochen reicht für die meisten Marken aus.
Der häufigste Fehler: Teams starten mit zu vielen Prompts und zu wenigen Wiederholungen. Besser ist ein kleines, stabiles Set, das dafür konsequent über Wochen läuft. Der zweithäufigste Fehler ist, Modell‑Updates mit eigenem Versagen zu verwechseln, obwohl eine Drift‑Erkennung das sofort erklärt hätte.
Praxisbeleg: Erfahrung Von Harald Pfanner Und growResonance
Dieser Artikel stammt von Harald Pfanner, SEO‑ und Content‑Marketing‑Experte bei growResonance, der die Optimierung der llm sichtbarkeit für Agenturen und Marken täglich begleitet. Einige Tools bieten Funktionen, die genau die oben beschriebenen Anforderungen abdecken:
- Modellübergreifendes Tracking über verschiedene Sprachmodelle.
- Archivierung historischer Antworten inklusive Versions‑ und Drift‑Erkennung.
- White‑Label‑Reporting für Agenturen.
- API‑Zugang und Datenexport.
- Multi‑Client‑ und Multi‑Organisation‑Management mit rollenbasierter Zugriffssteuerung.
Agenturen, die diese Struktur einmal aufgesetzt haben, können ihren Kunden binnen kurzer Zeit konkret zeigen, ob und wie oft die eigene Marke in KI‑Antworten auftaucht, statt nur zu vermuten. Wer selbst prüfen möchte, wie eine Marke aktuell in ChatGPT abgebildet wird, kann das über den kostenlosen LLM‑Sichtbarkeits‑Check direkt testen.
Warum LLM‑Tracking Jetzt Priorität Haben Sollte
Ich sehe LLM‑Sichtbarkeit nicht als Randthema, sondern als KPI, der neben SEO und PR gleichrangig ins Reporting gehört. Die Fehler, die ich am häufigsten beobachte, sind nicht technischer Natur. Teams warten, bis der Wettbewerb erwähnt wird, statt selbst frühzeitig eine Baseline zu bauen, und genau diese Wartezeit lässt sich später schwer aufholen.
Meine Empfehlung: klein starten, mit einem festen Prompt‑Set und einem Modell, dann Schritt für Schritt auf weitere Modelle und in bestehende Dashboards integrieren. Wer jetzt beginnt, hat in einem Jahr eine Datenbasis, die andere erst aufbauen müssen. Und die Modelle werden sich weiter verändern, mit jedem Training. Wer keine Baseline hat, kann diese Veränderung nicht einmal erkennen.
— Harald Pfanner: SEO- und Content-Marketing-Experte, Redakteur bei growResonance
growResonance: Ihr Einstieg In Messbares LLM‑Tracking
Es gibt Tools, die modellübergreifendes Tracking, Archivierung und White‑Label‑Reporting in einer Plattform bündeln, statt dass Prompt‑Abfragen händisch in mehreren Fenstern parallel geführt werden müssen.
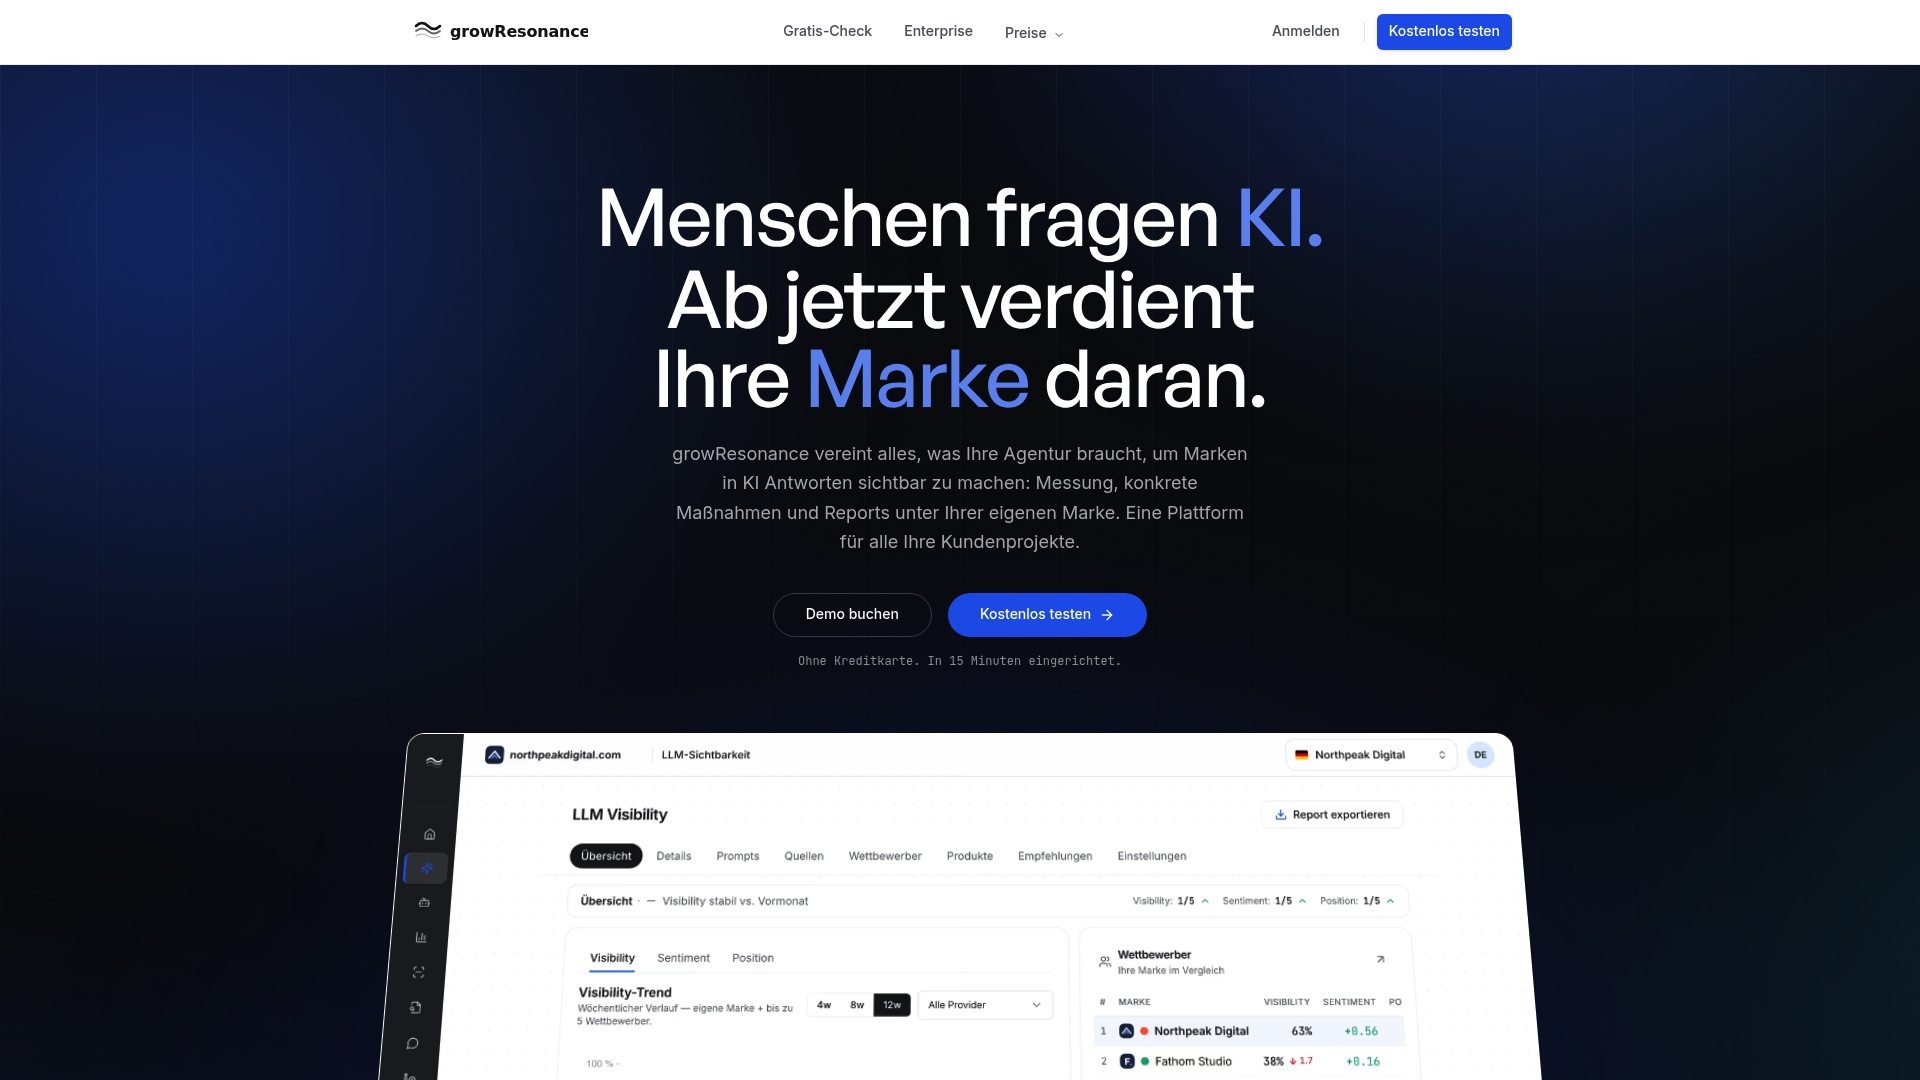
Für Agenturen bedeutet das weniger manuelle Arbeit pro Kunde und einen Report, der unter eigener Marke weitergereicht werden kann. Die Funktionen sind bewusst als Werkzeug gedacht, nicht als vollständig betreuter Managed Service. Sie behalten die Kontrolle über Prompt‑Sets, Reporting‑Rhythmus und Interpretation, das Tool liefert die verlässlichen Rohdaten dafür. Wer selbst einsteigen möchte, kann direkt mit dem Gratis‑Check für ChatGPT starten oder sich die Preise für Agenturen ansehen, bevor eine Demo angefragt wird. Für Marken ohne Agenturbindung gibt es eine eigene Preisübersicht für Marken.
Quellen
- AI Visibility Tracking (Meltwater)
- Wie man die Sichtbarkeit von LLM misst | Pippit
- ChatGPT Reaches 900M Weekly Active Users — TechCrunch
- LLM Visibility: Modellwissen und Retrieval trennen | Getmentioned
FAQ
Was Bedeutet LLM‑Sichtbarkeit Genau?
LLM‑Sichtbarkeit beschreibt, ob und wie eine Marke in Antworten von Sprachmodellen wie ChatGPT oder Perplexity erwähnt, zitiert oder empfohlen wird.
Welche Kennzahlen Sind Für LLM‑Tracking Am Wichtigsten?
Coverage, Mention Rate, Platzierung in der Antwort und Sentiment bilden das Grundgerüst; Prompt‑Coverage über mehrere Modelle ergänzt den Share of Voice.
Wie Unterscheidet Man Retrieval Von Modellwissen?
Mit derselben Frage einmal mit und einmal ohne aktivierte Websuche testen: Erscheint die Marke nur mit Suche, stammt die Nennung aus Retrieval, nicht aus dem trainierten Modellwissen.
Braucht Man Für LLM‑Tracking Mehrere Tools?
Nein, ein modellübergreifendes Tool wie growResonance deckt ChatGPT, Claude, Perplexity, Gemini und Google AI Overviews in einer Plattform ab, inklusive Archivierung und White‑Label‑Reporting.
Wie Oft Sollte Man LLM‑Sichtbarkeit Messen?
Ein wöchentlicher Rhythmus liefert ein solides Bild, tägliches Tracking eignet sich für Marken mit hoher Wettbewerbsdynamik oder häufigen Modell‑Updates.
Empfehlungen
- LLM‑Sichtbarkeit messen: die Anleitung
- Gibt es Software, mit der Agenturen die KI-Sichtbarkeit ihrer Kunden tracken können?
- Agentur-Leistung KI-Sichtbarkeit verkaufen
- KI-modellübergreifendes Monitoring von Markenerwähnungen: Gibt es Plattformen, die alles bündeln?
Transparenzhinweis (Art. 50 EU-KI-Verordnung): Die Texte und Bilder (Header-Grafiken) auf dieser Seite wurden mit Unterstützung von generativer KI (Large Language Models & Bildgeneratoren) erstellt und anschließend durch unsere SEO-Experten redaktionell geprüft und freigegeben.


